Autor: Redaktion Training Company Online Veröffentlichungsdatum: Noch festzulegen Lesezeit: ca. 8 Minuten
Ein mittelständischer Maschinenbauer investiert in seine Website. Die Produktbeschreibungen sind ausführlich, technische Datenblätter stehen zum Download bereit, und in der Google-Suche ist das Unternehmen bei relevanten Suchbegriffen vertreten.
Dann stellt ein potenzieller Kunde ChatGPT eine Frage: „Welche Anbieter in Deutschland liefern Anlagen für diesen Produktionsprozess?“
Die Antwort enthält mehrere Wettbewerber. Der Maschinenbauer fehlt.
Vielleicht kennt das KI-System das Unternehmen nicht oder hält andere Anbieter für geeigneter. Es könnte aber auch ein technisches Problem vorliegen: Die Informationen sind zwar auf der Website vorhanden, werden von den relevanten Systemen jedoch nicht oder nur unvollständig erfasst.
Bevor das Marketing zusätzliche Inhalte produziert oder Geld in GEO-Maßnahmen investiert, lohnt sich deshalb eine grundlegende technische Prüfung.
Was bedeutet es, wenn eine KI eine Website „sieht“?
Eine KI besucht Websites nicht zwangsläufig so wie ein Mensch. Viele KI-gestützte Suchfunktionen verwenden Suchindizes, automatisierte Crawler und Verfahren zur Auswahl relevanter Quellen.
Damit Informationen in einer KI-Antwort erscheinen können, müssen mehrere Voraussetzungen erfüllt sein.
Zunächst muss die Information auffindbar sein. Ein Crawler benötigt Zugang zu einer Seite, etwa über eine bekannte URL, einen Suchindex oder eine interne Verlinkung.
Anschließend muss er den Inhalt erfassen können. Dazu muss der Server die benötigten Informationen liefern, und diese müssen für das jeweilige System technisch lesbar sein.
Schließlich muss das System die Information für eine konkrete Antwort auswählen. Ob das geschieht, hängt unter anderem von der Frage, den verfügbaren Quellen und dem Auswahlverfahren des jeweiligen Systems ab.
Diese Vorgänge müssen getrennt betrachtet werden. Eine erfolgreiche Seitenabfrage beweist noch nicht, dass der Inhalt in einem Suchindex gespeichert wurde. Und selbst eine indexierte Website muss in einer KI-Antwort nicht erscheinen.
Für die Unternehmenspraxis ist diese Unterscheidung wichtig: Wer technische Zugänglichkeit, Auffindbarkeit und tatsächliche KI-Sichtbarkeit miteinander verwechselt, kann die Ursache einer schwachen Präsenz falsch einschätzen.
Google, ChatGPT und andere KI-Systeme greifen unterschiedlich auf Websites zu
Unternehmen sollten zunächst klären, welche technischen Zugriffe für sie relevant sind.
Bei Google gelten für AI Overviews und AI Mode weiterhin die grundlegenden Anforderungen der Google-Suche. Eine Seite muss indexiert sein und grundsätzlich als Suchergebnis mit einem Textausschnitt angezeigt werden können, um als unterstützender Link infrage zu kommen.
OpenAI unterscheidet hingegen mehrere Crawler mit unterschiedlichen Aufgaben.
| Crawler | Hauptaufgabe |
|---|---|
| Googlebot | Erfassung von Seiten für die Google-Suche, einschließlich ihrer KI-Funktionen |
| OAI-SearchBot | Erfassung von Websites für Suchfunktionen in ChatGPT |
| GPTBot | Erfassung von Inhalten, die für das Training von KI-Modellen verwendet werden können |
| ChatGPT-User | Aufruf von Websites bei bestimmten nutzerinitiierten Aktionen |
Für Unternehmen ist insbesondere der Unterschied zwischen OAI-SearchBot und GPTBot interessant. Nach der offiziellen Dokumentation von OpenAI kann ein Websitebetreiber den Suchcrawler zulassen und gleichzeitig den Trainingscrawler ausschließen.
Wer verhindern möchte, dass bestimmte Inhalte für das Modelltraining verwendet werden, muss deshalb nicht automatisch auf die Auffindbarkeit in ChatGPT Search verzichten.
Allerdings unterscheiden sich die Einstellungen der einzelnen Anbieter. Eine allgemeine Regel, mit der sämtliche KI-Systeme gleichermaßen gesteuert werden können, gibt es nicht.
Warum eine funktionierende Website für Crawler unzugänglich sein kann
Stellen wir uns einen B2B-Anbieter vor, der industrielle Messsysteme vertreibt. Ein Interessent öffnet die Produktseite und sieht Gerätebilder, technische Eigenschaften, verfügbare Schnittstellen und Anwendungsgebiete.
Ein automatisierter Crawler ruft dieselbe Seite auf. Im ursprünglichen HTML findet er jedoch hauptsächlich Navigationselemente und einen leeren Bereich. Die Produktinformationen werden erst später durch JavaScript geladen und vom Browser eingefügt.
Google kann viele JavaScript-Inhalte verarbeiten. Die offizielle Dokumentation beschreibt ausdrücklich einen zusätzlichen Rendering-Prozess, bei dem JavaScript ausgeführt wird.
Das bedeutet jedoch nicht, dass sämtliche Crawler jede Website auf dieselbe Weise verarbeiten. Manche führen kein oder nur eingeschränkt JavaScript aus.
Für den beispielhaften Messgerätehersteller entsteht damit ein Problem: Die technischen Produkteigenschaften sind möglicherweise nicht für alle relevanten Systeme zugänglich.
Ein geeigneter Ansatz besteht darin, zentrale Informationen bereits im ausgelieferten HTML bereitzustellen, beispielsweise durch serverseitiges Rendering. Welche technische Lösung sinnvoll ist, hängt vom verwendeten Content-Management-System und der Websitearchitektur ab.
Sieben Prüfungen für die technische KI-Zugänglichkeit
Für eine erste Untersuchung müssen Geschäftsführer oder Marketingverantwortliche nicht selbst programmieren. Sie sollten allerdings wissen, welche Fragen sie an ihre SEO-Verantwortlichen und Webentwickler stellen müssen.
1. Sind die wichtigsten Seiten überhaupt im Google-Index?
Die erste Prüfung betrifft die Seiten, über die das Unternehmen gefunden werden möchte. Bei einem B2B-Anbieter sind das beispielsweise Leistungsbeschreibungen, Produktseiten, relevante Branchenlösungen und technische Fachartikel.
In der Google Search Console lässt sich für einzelne URLs untersuchen, ob Google sie indexiert hat und welche Probleme gegebenenfalls festgestellt wurden.
Eine Seite kann aus unterschiedlichen Gründen fehlen: Sie wurde noch nicht ausreichend entdeckt, enthält eine Indexierungssperre oder wird als Duplikat einer anderen Seite behandelt.
Was Sie prüfen sollten: Sind die fünf bis zehn wichtigsten kommerziellen und fachlichen Seiten im Index vorhanden? Falls nicht, welche Ursachen meldet die Search Console?
Eine positive Indexierungsprüfung beantwortet allerdings nur die Frage nach Google. Sie bestätigt keine Sichtbarkeit in ChatGPT oder anderen KI-Systemen.
2. Werden relevante Crawler versehentlich blockiert?
Im Stammverzeichnis vieler Websites liegt eine Datei namens robots.txt. Sie enthält Anweisungen, welche Bereiche bestimmte Crawler aufrufen dürfen.
Eine fehlerhafte oder zu weit gefasste Sperre kann verhindern, dass relevante Systeme auf wichtige Seiten zugreifen. Zusätzlich können sogenannte noindex-Anweisungen in den HTML-Metadaten oder HTTP-Antworten die Indexierung beeinflussen.
Dabei ist eine technische Unterscheidung wichtig: robots.txt steuert den Zugriff durch kooperierende Crawler. noindex teilt unterstützenden Suchsystemen mit, dass eine Seite nicht indexiert werden soll.
Ist eine URL bereits durch die robots.txt gesperrt, kann der Suchcrawler die auf der Seite hinterlegte noindex-Anweisung unter Umständen gar nicht lesen.
Was Sie prüfen sollten: Welche Crawler sind zugelassen? Sind wichtige Seiten versehentlich gesperrt? Gibt es widersprüchliche Regeln?
Die Freigabe sollte bewusst erfolgen. Nicht jeder Crawler benötigt Zugang zu jedem Unternehmensinhalt.
3. Lässt der Webserver die Crawler tatsächlich durch?
Selbst eine korrekt konfigurierte robots.txt garantiert noch keinen erfolgreichen Zugriff.
Viele Unternehmen verwenden Firewalls, CDN-Dienste und spezielle Bot-Schutzsysteme, um automatisierte Angriffe, unerwünschte Bots und ungewöhnlichen Datenverkehr abzuwehren.
Diese Sicherheitsmaßnahmen können allerdings auch erwünschte Crawler blockieren. Die Website erlaubt einem Suchbot dann formal den Zugriff, der Server verweigert ihm aber die angeforderte Seite.
Die Ursachen lassen sich häufig anhand der Serverprotokolle untersuchen. Dort ist beispielsweise erkennbar, ob bestimmte Anfragen erfolgreich beantwortet oder zurückgewiesen wurden. Auch die Identität des Crawlers muss geprüft werden, da sich eine Kennung im User-Agent technisch nachahmen lässt.
Was Sie prüfen sollten: Können die relevanten Crawler die wichtigsten Seiten tatsächlich abrufen? Welche HTTP-Statuscodes liefern Server und Schutzsysteme?
4. Sind die entscheidenden Informationen im HTML verfügbar?
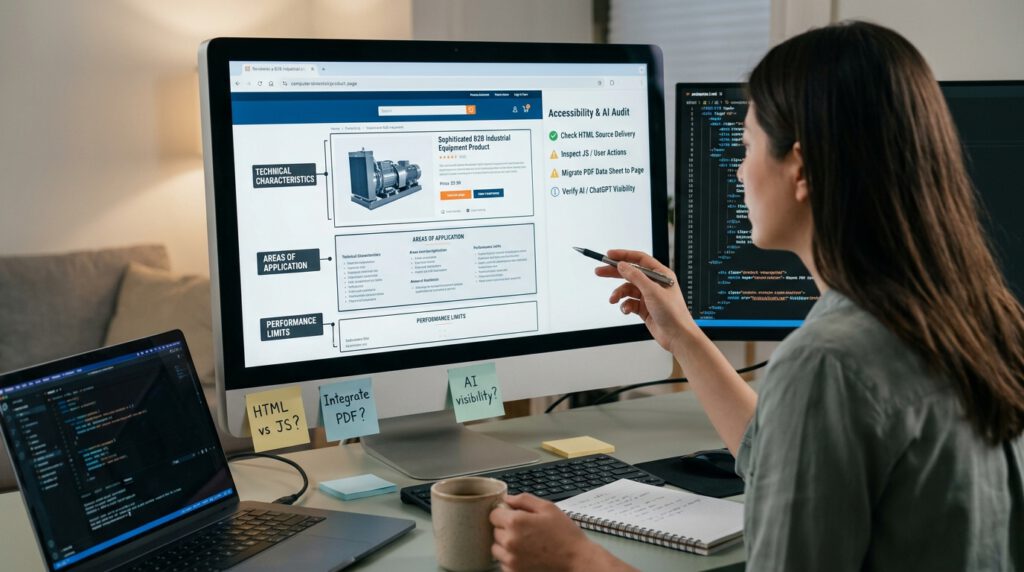
Eine besonders wichtige Prüfung betrifft den eigentlichen Inhalt. Für einen potenziellen B2B-Kunden können technische Eigenschaften, Einsatzbereiche, Lieferbedingungen oder Leistungsgrenzen ausschlaggebend sein.
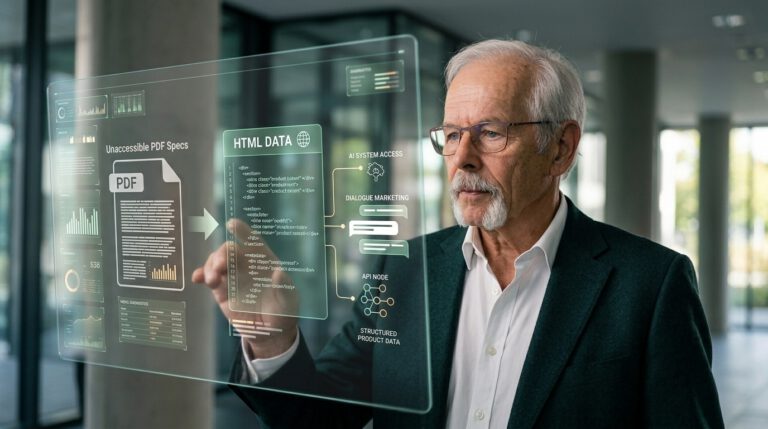
Wenn diese Informationen ausschließlich in Bildern, interaktiven Oberflächen oder erst nach einer Nutzeraktion verfügbar sind, kann ihre automatisierte Erfassung erschwert werden.
PDF-Dateien sind dabei nicht grundsätzlich unsichtbar. Google kann beispielsweise zahlreiche PDF-Dokumente indexieren. Trotzdem ist es sinnvoll, entscheidende Informationen zusätzlich als strukturierten Text auf passenden HTML-Seiten anzubieten.
Ein Praxisbeispiel:
Ein Hersteller beschreibt auf seiner Website ein Messgerät lediglich als „leistungsfähige Lösung für industrielle Anwendungen“. Die konkreten Messbereiche, Schnittstellen und Einsatzbedingungen befinden sich in einem Datenblatt.
Ein anderes Unternehmen nennt diese Eigenschaften direkt auf der Produktseite. Bei einer konkreten technischen Anfrage liefert diese Seite den benötigten Sachverhalt unmittelbar im HTML. Das erleichtert die automatische Verarbeitung, ohne eine spätere Auswahl als Quelle zu garantieren.
Was Sie prüfen sollten: Sind die wichtigsten kaufentscheidenden Informationen auch ohne Nutzerinteraktion im ausgelieferten oder zuverlässig gerenderten HTML verfügbar?
Praxis-Check: Was sieht ein Crawler auf Ihrer Produktseite?
Wählen Sie eine Ihrer wichtigsten Produktseiten aus und lassen Sie prüfen, ob technische Eigenschaften, Einsatzbereiche und Leistungsgrenzen bereits im ausgelieferten oder zuverlässig gerenderten HTML enthalten sind.
Stehen diese Angaben ausschließlich in einem Datenblatt oder erscheinen sie erst nach einer Nutzeraktion, sollte die technische Bereitstellung untersucht werden.
Der Test zeigt, ob wichtige Informationen technisch erfassbar sind. Ob ein KI-System die Seite später als Quelle verwendet, lässt sich daraus nicht ableiten.
5. Stimmen Seitenstruktur und URLs?
Probleme können auch entstehen, wenn eine Website zahlreiche technische Varianten derselben Seite bereitstellt. Ein Produkt ist beispielsweise über unterschiedliche Parameter, Filter oder alte URLs erreichbar.
Mit dem sogenannten Canonical-Tag kann der Websitebetreiber eine bevorzugte Seitenversion angeben. Suchmaschinen berücksichtigen dieses Signal, müssen ihm aber nicht zwangsläufig folgen.
Hinzu kommt die XML-Sitemap. Sie hilft Suchmaschinen, relevante URLs zu entdecken, ersetzt jedoch keine funktionierende interne Verlinkung.
Schwierigkeiten entstehen für Unternehmen vor allem dann, wenn ausgerechnet die wichtigsten Inhalte schlecht erreichbar sind, auf veraltete Adressen weiterleiten oder mit widersprüchlichen Canonical-Angaben versehen wurden.
Was Sie prüfen sollten: Sind die wichtigsten Seiten intern verlinkt, über ihre vorgesehenen URLs erreichbar und in der Sitemap korrekt aufgeführt?
6. Lassen sich Produkte, Unternehmen und Fachinformationen eindeutig zuordnen?
Technische Zugänglichkeit allein beantwortet noch nicht, ob ein KI-System die Informationen richtig einordnet.
Ein B2B-Unternehmen sollte auf seinen Seiten deshalb konkrete Angaben machen. Bei einem technischen Dienstleister wären beispielsweise die angebotenen Leistungen, Einsatzgebiete, unterstützten Systeme und fachlichen Ansprechpartner relevant.
Für Fachartikel sind eine nachvollziehbare Autorenschaft, das tatsächliche Veröffentlichungsdatum und geeignete Quellen sinnvoll.
Strukturierte Daten nach Schema.org können Suchsystemen helfen, bestimmte Angaben maschinenlesbar einzuordnen. Sie müssen jedoch mit dem sichtbaren Inhalt übereinstimmen.
Google weist ausdrücklich darauf hin, dass für seine KI-Suchfunktionen keine spezielle KI-Auszeichnung erforderlich ist. Eine einzelne zusätzliche Datei oder ein neues Schema macht eine Website also nicht automatisch für KI sichtbar.
Was Sie prüfen sollten: Können Besucher und automatisierte Systeme zuverlässig erkennen, welches Unternehmen welche Leistungen anbietet und worauf fachliche Aussagen beruhen?
7. Enthält die mobile Website alle wichtigen Informationen?
Google verwendet für die Indexierung die mobile Version einer Website.
Das kann für B2B-Unternehmen relevant werden, deren Desktopseiten umfangreiche technische Angaben enthalten, während die Smartphoneansicht stark reduziert wurde.
Eine kompaktere Darstellung ist nicht automatisch problematisch. Inhalte dürfen beispielsweise in aufklappbaren Bereichen stehen. Entscheidend ist, ob der wesentliche Inhalt weiterhin technisch zugänglich bleibt.
Was Sie prüfen sollten: Sind wichtige Leistungsbeschreibungen, Produktdaten und interne Links auf der mobilen Version ebenso verfügbar wie auf dem Desktop?
Welche Fehler sollten Unternehmen zuerst beheben?
Nicht jede technische Auffälligkeit hat dieselbe wirtschaftliche Bedeutung. Eine kleine Darstellungsabweichung auf einer wenig besuchten Archivseite ist anders zu bewerten als eine Zugriffsblockade auf der zentralen Produktseite eines wichtigen Geschäftsbereichs.
Für die Priorisierung hilft deshalb eine Frage:
Welche Informationen benötigt ein potenzieller Kunde, um unser Unternehmen bei seiner Kaufentscheidung überhaupt berücksichtigen zu können?
Bei einem Anlagenhersteller können dies technische Spezifikationen und Einsatzbedingungen sein. Bei einem Beratungsunternehmen sind es häufig konkrete Leistungen, Branchenkenntnisse und die nachvollziehbare Beschreibung der Arbeitsweise.
Die Seiten mit diesen Informationen sollten zuerst technisch geprüft werden.
Eine aufwendige Gesamtsanierung ist nicht immer notwendig. Manchmal lässt sich eine gravierende Zugangssperre mit einer gezielten Konfigurationsänderung beheben. Bei komplexen JavaScript-Anwendungen oder systematischen URL-Problemen kann der Aufwand dagegen erheblich größer sein.
Wie erkennt man, ob die Verbesserungen tatsächlich etwas bringen?
Nach einer technischen Korrektur muss zunächst kontrolliert werden, ob die betroffenen Seiten für die gewünschten Crawler zugänglich sind.
Anschließend sollten Marketing und Vertrieb prüfen, wie das Unternehmen in relevanten Suchsituationen dargestellt wird. Dazu eignen sich dokumentierte Testfragen, beispielsweise:
„Welche Anbieter liefern industrielle Messsysteme für [konkrete Anwendung]?“
„Welche Unternehmen bieten [bestimmte B2B-Dienstleistung] in Deutschland an?“
„Worin unterscheiden sich die Lösungen von [Anbieter A] und [Anbieter B]?“
Solche Tests zeigen, ob und in welchem Zusammenhang ein Unternehmen in Antworten erscheint, welche Quellen genannt werden und ob die Angaben zutreffen.
Ein einzelner Test reicht für eine belastbare Bewertung allerdings nicht aus. KI-Antworten können sich zwischen Sitzungen, Fragestellungen und Zeitpunkten unterscheiden.
Auch Serverprotokolle liefern nur einen Teil der Antwort. Der erfolgreiche Besuch eines Crawlers beweist nicht, dass die Seite später in einer KI-Antwort zitiert wird.
Für eine wirtschaftliche Bewertung sollten zusätzlich tatsächlich messbare Websitebesuche, qualifizierte Anfragen und weitere geeignete Geschäftsergebnisse betrachtet werden, soweit die verfügbaren Daten eine Zuordnung erlauben.
Technische Zugänglichkeit ist der Anfang, nicht das Ergebnis
Ein technischer GEO-Check beantwortet zunächst eine grundlegende Frage: Können relevante Systeme auf die Informationen eines Unternehmens zugreifen?
Ist die Antwort negativ, besteht konkreter Handlungsbedarf.
Ist die Website technisch gut zugänglich, richtet sich der Blick auf andere Faktoren: die Qualität der veröffentlichten Informationen, ihre fachliche Relevanz, die externe Auffindbarkeit des Unternehmens und die Fragen, die potenzielle Kunden tatsächlich stellen.
Auch ein technisch fehlerfreier Internetauftritt muss nicht zwangsläufig in KI-Antworten auftauchen.
Umgekehrt ist es wenig sinnvoll, erhebliche Mittel in neue GEO-Inhalte zu investieren, solange unklar ist, ob die relevanten Systeme die vorhandenen Seiten überhaupt zuverlässig erfassen können.
Quellen
1. Google Search Central: KI-Funktionen und deine Website – technische Voraussetzungen für die Sichtbarkeit in der Google-Suche. https://developers.google.com/search/docs/appearance/ai-features?hl=de
2. OpenAI: Overview of OpenAI Crawlers – offizielle Dokumentation zu OAI-SearchBot, GPTBot und ChatGPT-User. https://developers.openai.com/api/docs/bots
3. Google Search Central: Grundlagen von JavaScript-SEO – Crawling, Rendering und Indexierung JavaScript-basierter Websites. https://developers.google.com/search/docs/crawling-indexing/javascript/javascript-seo-basics?hl=de
4. Google Search Central: Best Practices für mobile Websites und die Mobile-First-Indexierung. https://developers.google.com/search/docs/crawling-indexing/mobile/mobile-sites-mobile-first-indexing?hl=de
5. Google Search Central: Einführung und Leitfaden zu robots.txt-Dateien. https://developers.google.com/search/docs/crawling-indexing/robots/intro?hl=de